Реальная стоимость заказной интеграции LLM в 2025 году и почему большинство пилотов не доходят до продакшена
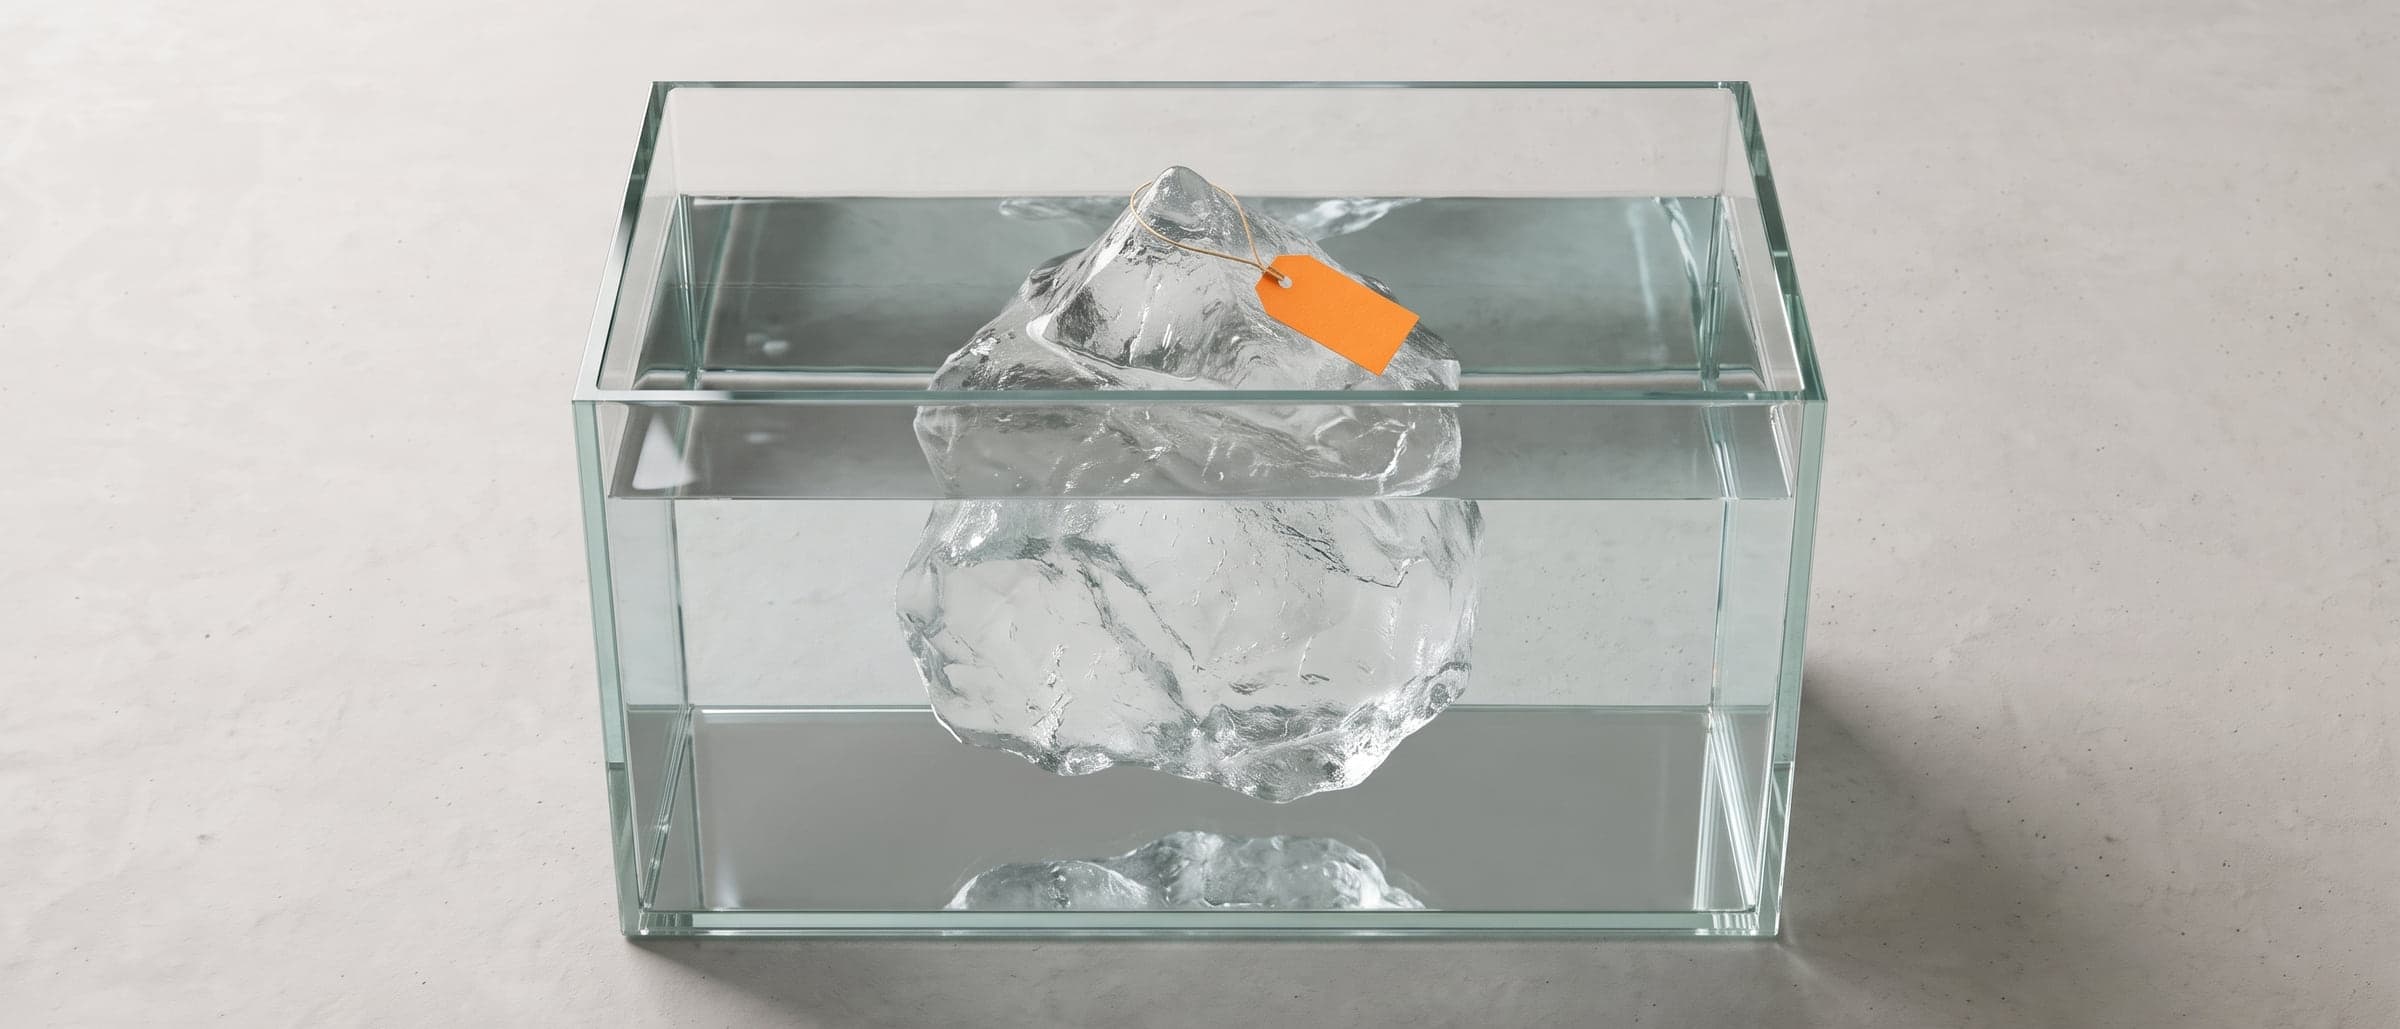
Названная цена интеграции LLM редко совпадает с итоговой стоимостью, потому что сама модель — лишь одна часть промышленной системы. Остальной бюджет уходит на подготовку данных, инженерную интеграцию, мониторинг и регулярное дообучение. Закладывайте бюджет на всю систему целиком, а не только на доступ к API.
Бюджет, утверждённый на старте корпоративной AI-инициативы, редко покрывает систему, которая доходит до продакшена. Руководство выделяет средства на доступ к API и базовое внедрение, воспринимая генеративные модели как готовую функцию. Именно на этом непонимании стоимости разработки AI-приложений пилоты и останавливаются: пилот работает, а бюджета на то, что нужно для продакшена, нет.
Корневая причина — неспособность увидеть полную структуру затрат на развёртывание. Компании закладывают в бюджет модель, но платят за конвейер данных, систему оценки качества и постоянное сопровождение.
Почему названная цена редко равна итоговой?
Когда подрядчик называет цену заказной интеграции LLM для предприятия, он часто оценивает стоимость соединения API с интерфейсом. Это демо. Промышленная AI-система требует детерминированной надёжности от вероятностной модели. Достижение такой надёжности требует строгой инженерии вокруг самой модели.
Лицензии и плата за API — лишь одна часть совокупной стоимости владения. Остальное составляют инфраструктура, подготовка данных и непрерывный мониторинг.
Из каких слоёв затрат состоит промышленная LLM-система?
Устойчивая интеграция LLM состоит из пяти отдельных слоёв затрат:
- Подготовка данных
Подготовка, очистка и разметка данных занимают более 80% времени в AI-проектах (Cognilytica, 2019). Векторизация данных, настройка прав доступа и очистка неструктурированных документов для RAG — самый ресурсоёмкий этап.
- Лицензии базовой модели и плата за API
Предсказуемые регулярные расходы на токены. Стоимость базового инференса снижается, но высоконагруженные транзакционные системы всё равно дают существенные ежемесячные вычислительные расходы.
- Инженерия интеграции
Написание соединительной ткани: оркестрация промптов, маршрутизация API, запасные пути и логика, привязывающая модель к корпоративным данным.
- MLOps и мониторинг
Модели деградируют. LLM требуют наблюдаемости для отслеживания дрейфа, доли галлюцинаций и задержек.
- Постоянное дообучение и оптимизация
По мере изменения корпоративных данных эмбеддинги и дообученные веса нужно обновлять.
В чём разрыв между «готово для демо» и «готово для продакшена»?
Пилоты проваливаются, потому что архитектура, работающая для десяти тестировщиков прототипа, рассыпается под одновременной корпоративной нагрузкой. Демо опирается на чистый статичный набор данных. Промышленная система обязана выдерживать пропуски в данных, неоднозначные запросы и лимиты частоты обращений к API.
При переходе пилота в продакшен фокус инженерии смещается с «сможет ли модель ответить» на «что произойдёт, когда модель выдумает ответ, нарушающий требования регулятора». Разрыв закрывают ограничители, конвейеры оценки и слои кеширования — и эта работа почти никогда не учтена в бюджете пилота.
- Лицензии и оплата APIЛишь часть совокупной стоимости владения
- API, подключённый к интерфейсуЭто демоверсия
Что обычно оценивают в смете подрядчика
Почти никогда не заложено в бюджет пилота
- Подготовка данныхСамый ресурсоёмкий этап
- Интеграционная разработкаОркестрация промптов, маршрутизация API, резервные сценарии
- MLOps и мониторингДрейф данных, частота галлюцинаций и задержки
- Регулярное дообучениеОбновление эмбеддингов и весов по мере изменения данных
- Защитные фильтры, конвейеры оценки, кэшированиеЧто выводит проект в продакшен
Как оценить объём работ по LLM?
До выделения бюджета на AI-интеграцию технический руководитель должен ответить на четыре вопроса:
- Где лежат эталонные данные и доступны ли они через API?
- Какая задержка генерации ответа приемлема?
- Как мы будем количественно измерять точность вывода модели?
- Каков запасной механизм, когда модель отказывает или возвращает небезопасный ответ?
Пока эти вопросы без ответа, любая оценка бюджета — догадка.
Чем полезен этап исследования?
Пилот пишет код, чтобы проверить, возможна ли идея. Исследование определяет точную архитектуру, требования к данным и финансовую модель, необходимые для работы системы под нагрузкой. Вместо одноразового прототипа этап исследования размечает конвейеры данных, даёт архитектурный бриф и реестр технических рисков с фиксированным объёмом.
Не финансируйте интеграцию исходя из стоимости API. Проведите аудит готовности данных и разметьте промышленную архитектуру до первой строки кода.
Часто задаваемые вопросы
Почему ИИ-пилоты застревают перед выходом в продакшен?
Пилот работает, но бюджет на доведение системы до продакшена не заложен. Демоверсия опирается на чистые статичные данные и пару тестировщиков. Промышленная система обязана справляться с пропусками в данных, неоднозначными запросами, параллельной нагрузкой и лимитами запросов к API.
Из чего складывается стоимость интеграции LLM помимо оплаты API?
Лицензии и оплата API — лишь малая часть совокупной стоимости владения. Самая ресурсоёмкая статья — подготовка данных. Остальную часть составляют инженерная интеграция, мониторинг и дообучение по мере изменения корпоративных данных.
На какие вопросы нужно ответить перед расчётом бюджета на ИИ-интеграцию?
Ответьте на четыре вопроса. Где хранятся эталонные данные и доступны ли они по API? Какая задержка ответа допустима? Как будет измеряться точность? Какой предусмотрен резервный сценарий на случай сбоя модели? Пока на них нет ответа, любая оценка остаётся догадкой.
Чем этап исследования помогает в проектах с LLM?
Пилот проверяет саму идею на реализуемость. Этап исследования определяет архитектуру, требования к данным и финансовую модель для работы системы под нагрузкой. По его итогам вы получаете схему конвейеров данных, архитектурный бриф и реестр технических рисков.
Нужна помощь с похожим проектом?
Обсудите с нашей командой вашу ситуацию. Без продающих речей — просто разговор.
Поговорить с командой →Услуга: AI-разработка →